42plugin-eval
技能评估套件:用断言测试和盲测对比,量化技能的真实贡献
技能越来越多,但哪个真的有用?42eval 用断言测试 + 盲测对比,量化每个技能的实际贡献。
为什么需要评测技能?
一个技能可能让 AI 的输出结构更清晰,也可能只是多绕了一圈,结果和直接问 AI 差不多。更糟的情况是,技能反而限制了模型本身的能力,输出质量不升反降。
没有评测,这些都只能靠感觉。42eval 把感觉变成数据。
如何启用
42eval 是 42plugin CLI 的内置功能,默认关闭。先确认 CLI 版本在 0.3.9 或更高:
42plugin --version
42eval 需要 42plugin CLI 0.3.9 或更高版本。运行 42plugin upgrade 升级到最新版。
如果还没有安装 CLI:
curl -fsSL https://get.42plugin.com/cli | bash
irm https://get.42plugin.com/cli.ps1 | iex
然后开启:
42plugin builtin enable 42plugin-eval
启用后你会获得:
- 命令行工具
42plugin eval:适合批量操作和自动化 - 交互式技能
/42plugin-eval:在 Claude Code 中使用,AI 引导你完成评测
你还需要一个要评测的 Skill。本页教程以 psych-review(心理学文献综述)为例,用你自己写的任何 Skill 都可以照着做。
核心方法:衡量技能的增量贡献
42eval 不问「输出好不好」,而是问「相比不用技能,输出多了什么」。
用同一道题考两遍:一遍让 AI「带着技能」答题,一遍让 AI「裸考」。然后对比两份答卷,逐条检查断言是通过还是失败。差值就是技能的真实贡献。
断言的四种分类
| 分类 | 检查什么 | 举例 |
|---|---|---|
| structure(结构) | 输出有没有特定的章节、表格、代码块 | 「包含 PICOS 五个章节标题」 |
| content(内容) | 有没有特定的实质性内容 | 「至少分析了 3 个核心实体」 |
| differential(差异化) | 没有技能就做不到的事 | 「使用了技能定义的三阶段分析法」 |
| quality(质量) | 整体输出质量是否达标 | 「给出了可执行的下一步建议」 |
其中 differential(差异化) 断言是重点:它检查的是「只有用了技能才会出现的东西」。每道考题至少要有 2 条差异化断言,否则无法区分「模型本来就会做」和「技能帮了忙」。
技能矩阵:四种技能类型
42eval 用一个 2×2 矩阵刻画技能的价值来源:AI 模型自身能力和技能编码的人类经验质量。
| 模型能力强 | 模型能力弱 | |
|---|---|---|
| 人类经验高 | mastery(精通) | codification(规范) |
| 人类经验低 | leverage(杠杆) | scaffolding(脚手架) |
不同象限的技能,价值来源和评测策略不同。42plugin eval classify 会自动分析并推荐对应的评测策略。
断言健康度:评测你的评测
评测完成后,每条断言会被标记健康状态:
| 状态 | 含义 | 建议 |
|---|---|---|
| skill-differential(技能价值) | 带技能通过,裸考失败 | 保留,这是技能的核心贡献 |
| always-pass(始终通过) | 两侧都通过 | 替换,断言没有区分度 |
| always-fail(始终失败) | 两侧都失败 | 检查,断言可能不合理 |
| inverse(反向) | 裸考反而通过 | 排查,技能可能帮了倒忙 |
两种使用方式
两种方式效果完全一样,产出的数据格式和报告也一致,区别只在操作体验:
| 交互式(推荐新手) | 命令行 | |
|---|---|---|
| 怎么启动 | 在 Claude Code 中输入 /42plugin-eval | 在终端输入 42plugin eval run |
| 体验 | AI 一步步引导你,像对话 | 你自己准备好用例,一键执行 |
| 适合 | 第一次用、想学习流程 | 批量评测、集成到自动化流程 |
方式一:在 Claude Code 中交互式评测
适合第一次使用或快速评测一个技能。
/42plugin-eval
AI 会引导你走完六个阶段,你不需要记任何命令,只需要回答 AI 的问题。
- 给技能做「体检分类」:AI 读取 Skill 内容,判断它属于哪个象限,不同类型用不同的评测方式。
- 搭建评测工作区:在项目目录下创建
.42eval/技能名/,存放所有评测数据。 - 设计「考题」:这是最关键的一步。AI 帮你想出 3-5 个测试场景,并为每道题设计评判标准(断言),例如「输出必须包含 PICOS 五个组成部分」。你可以修改和补充。
- 正式「考试」:同一道题考两遍,一遍带技能,一遍裸考,再对比两份答卷,看每条断言通过还是失败。
- 出成绩单:汇总所有考题的结果,生成可视化的 HTML 报告。
- 根据成绩改进:报告会告诉你技能哪里好、哪里需要改。改完可以再评测一轮,看是否进步。
方式二:命令行独立运行
适合批量评测或 CI 集成。
# 1. 给技能分类
42plugin eval classify <技能路径>

# 2. 初始化评测工作区
42plugin eval init <技能路径>

# 3. 编写测试用例(在 .42eval/技能名/cases/ 目录下创建 JSON 文件)

# 4. 运行评测
42plugin eval run <技能路径> -i 1

# 5. 查看统计摘要
42plugin eval benchmark <技能路径> -i 1

# 6. 生成可视化报告
42plugin eval report <技能路径> -i 1 --open
读懂评测结果
关键指标是 delta(增量):用了技能后,断言通过率比不用技能高出多少。
| delta | 评价 | 含义 |
|---|---|---|
| > 30% | 优秀 | 技能价值非常显著 |
| 20–30% | 良好 | 技能有明确效果 |
| 10–20% | 及格 | 有一定帮助,还能优化 |
| < 10% | 不及格 | 技能可能需要重新设计 |
迭代改进
评测不是终点,而是改进的起点:
# 修改技能后重新快照(保留旧版本存档)
42plugin eval init <技能路径> --force

# 用新版本号跑第二轮评测
42plugin eval run <技能路径> -i 2

# 查看两轮之间的提升
42plugin eval benchmark <技能路径> -i 2
benchmark 会自动计算 version_delta(版本间增量),告诉你这次改进提升了多少。同时记得更新断言:把「始终通过」的换成更有挑战性的版本,让评测标准和技能一起成长。
命令速查
| 命令 | 说明 |
|---|---|
42plugin eval classify <路径> | 技能分类(属于哪个象限) |
42plugin eval init <路径> | 初始化评测工作区 |
42plugin eval init <路径> --force | 重新快照(技能改了之后用) |
42plugin eval run <路径> -i <轮次> | 运行完整评测 |
42plugin eval benchmark <路径> -i <轮次> | 查看统计摘要 |
42plugin eval report <路径> -i <轮次> --open | 生成并打开 HTML 报告 |
42plugin eval serve <路径> | 启动本地报告查看器 |
所有命令都支持 --json(输出机器可读的 JSON 格式)。
实战教程:评测 psych-review
下面用「心理学文献综述」技能 psych-review 走完一次完整的命令行评测。它指导 AI 按学术规范做系统性文献综述——听起来很专业,但它真的比直接问 AI 更好吗?
第一步:给技能分类
42plugin eval classify .claude/skills/psych-review
这条命令让 42eval 阅读技能内容,从两个维度分析:模型能力有多强,以及技能里编码的人类经验质量有多高。
输出示例:
2×2 矩阵分类结果
────────────────────────────────────────
  象限: mastery — 精通
  策略: comparison — 盲测对比
  模型自身能力: strong (68/100)
  人类经验: best (91/100)
  置信度: 0.8

矩阵定位:
          模型能力强(strong)    模型能力弱(weak)
        ┌──────────────────┬──────────────────┐
  人类  │ ★ mastery        │ codification     │
  经验高│   (精通)          │   (规范)          │
        ├──────────────────┼──────────────────┤
  人类  │ leverage         │ scaffolding      │
  经验低│   (杠杆)          │   (脚手架)        │
        └──────────────────┴──────────────────┘
psych-review 落在 mastery(精通) 象限:AI 模型本身就有一定的文献综述能力(68/100),同时技能编码了高质量的学术规范和工作流(91/100)。模型能干,技能也写得好,所以需要更严格的评测方式来区分「技能到底帮了多少忙」。技能落在其他象限也完全正常,只是说明价值来源不同,42eval 会自动匹配对应的评测策略。
第二步:初始化工作区
42plugin eval init .claude/skills/psych-review
这条命令做两件事:
- 在项目根目录下创建
.42eval/psych-review/文件夹 - 把技能内容拍一张「快照」保存下来(即使之后修改了技能,评测用的仍是当时的版本)
创建出来的目录结构:
.42eval/psych-review/
├── config.json            # 刚才的分类结果
├── skill-snapshot/        # 技能内容快照
└── cases/                 # 测试用例(现在是空的,等你来填)
第三步:编写测试用例
这一步是评测的核心:给技能出几道题,并定义好「什么算答对了」。在 cases/ 目录下创建 JSON 文件,每个文件是一道考题。psych-review 设计了 3 道题,下面是考题 1:PICOS 框架定义(cases/eval-1.json)。
{
  "caseId": "eval-1",
  "caseName": "Basic PICOS Framework",
  "prompt": "I need to conduct a systematic review on CBT for adolescent depression. Help me define the PICOS framework.",
  "expectations": [
    {
      "id": "exp-1",
      "description": "Response must define all 5 PICOS components",
      "category": "differential",
      "critical": true
    },
    {
      "id": "exp-2",
      "description": "Population must specify age range (e.g., 12-18 years)",
      "category": "differential",
      "critical": true
    },
    {
      "id": "exp-3",
      "description": "Must suggest creating project directory structure",
      "category": "structure",
      "critical": false
    }
  ]
}
字段很少:
- prompt(输入):你想让 AI 回答的问题
- expectations(断言):你期望输出应该满足的条件
- 每条断言有一个 category(分类,见上文四种分类)和 critical(是否关键)
不知道怎么写断言?在 Claude Code 中输入 /42plugin-eval,告诉 AI 想考什么题目,它的断言生成器会输出 5-6 条断言供你挑选和修改。
第四步:运行评测
42plugin eval run .claude/skills/psych-review -i 1
-i 1 表示「这是第 1 轮评测」,以后改进了技能可以用 -i 2 跑第 2 轮。系统会自动完成所有工作:
开始执行评测 (v1)
  技能: psych-review
  用例数: 3

[eval-1] Basic PICOS Framework
  执行 with_skill...          ← AI「带着技能」答题
  ✓ 已保存 (4435 字符)
  执行 without_skill...       ← AI「裸考」同一道题
  ✓ 已保存 (2348 字符)
  评分中...                    ← 评分器逐条检查断言
  ✓ 评分完成
  ✓ 完成

[eval-2] Database Search Strategy
  ...
  ✓ 完成

[eval-3] APA Citation Format
  ...
  ✓ 完成

聚合结果...

✓ 评测完成!
评分器对两份答卷逐条核对断言:通过还是失败,并引用原文作为证据。with_skill 的输出(4435 字符)比 without_skill(2348 字符)长了将近一倍,但长不等于好,所以需要断言来精确衡量。
第五步:看统计摘要
42plugin eval benchmark .claude/skills/psych-review -i 1
输出:
基准测试结果
──────────────────────────────────────────────────
  技能: psych-review
  迭代: v1
  评测数: 3

  with_skill 平均通过率: 100.0%
  without_skill 平均通过率: 77.8%
  delta: +22.2%

  断言健康度: 3 差异化 | 3 始终通过
关键数字是 delta: +22.2%:用了技能后,断言通过率比不用技能高出 22.2 个百分点,落在「良好」区间,技能确实有用。
最后一行「断言健康度」评估的是你出的考题质量:3 条「差异化」确实能区分技能的贡献;3 条「始终通过」太简单,AI 不用技能也能通过,后面需要替换成更有挑战性的版本。
第六步:打开评测报告
统计摘要只是概览。42eval 真正的亮点是一份交互式 HTML 报告:
42plugin eval report .claude/skills/psych-review -i 1 --open
浏览器会自动打开一份深色主题的报告页面。
如何读懂评测报告
报告首页:三个数字说清全局
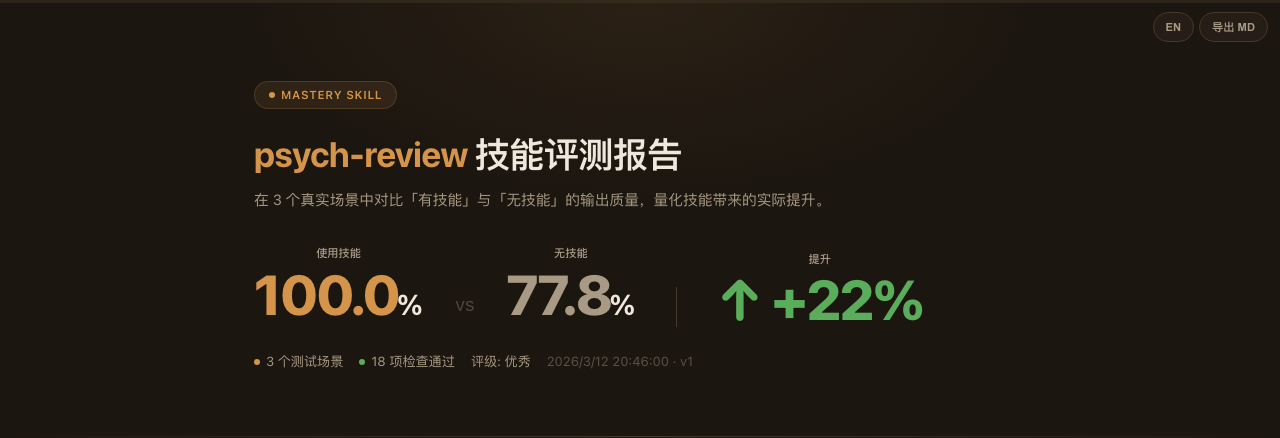
首页是三个大数字:
- 100.0%(使用技能的通过率):AI「带着技能」答题时,所有断言全部通过
- 50.0%(无技能的通过率):AI「裸考」时,只有一半的断言通过
- +50%(提升幅度):技能带来的提升量
页面顶部的橙色标签 MASTERY SKILL 表示这个技能属于「精通」象限。底部还有几个辅助信息:3 个测试场景、18 项检查通过、评级「优秀」。
场景对比:哪道题最能体现技能的价值
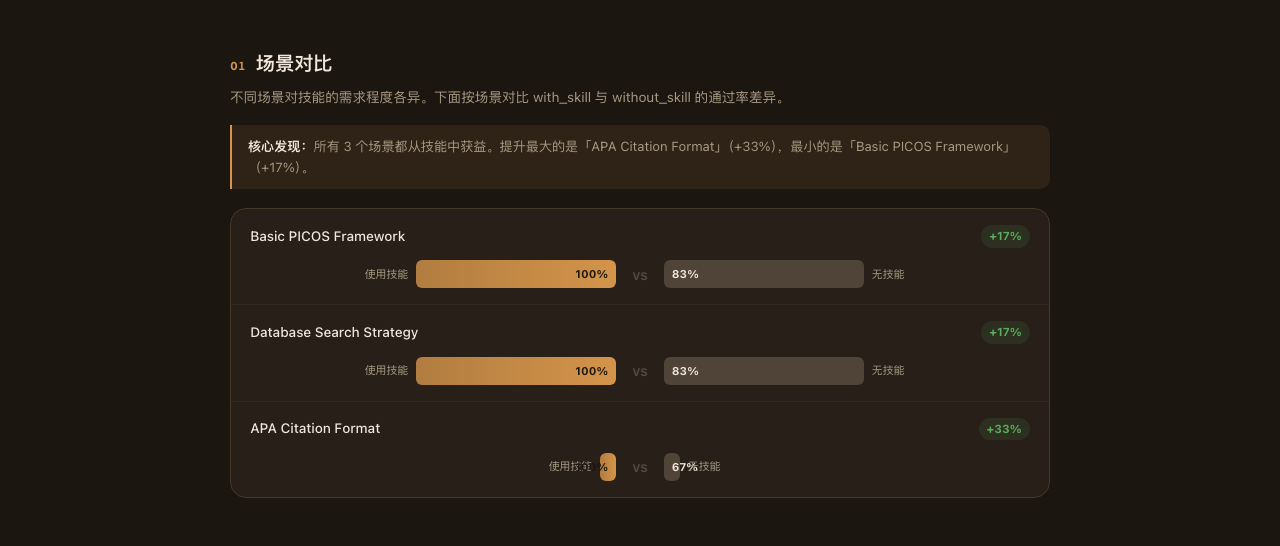
往下是一组「蝴蝶图」:左边橙色条是「使用技能」的通过率,右边灰色条是「无技能」的通过率。三道考题的对比:
- Basic PICOS Framework(PICOS 框架定义):+100%。AI 裸考得了 0 分,带技能满分,说明技能提供了模型完全不具备的能力
- APA Citation Format(APA 引用格式):+33%。技能在学术格式规范上有明确帮助
- Database Search Strategy(数据库搜索策略):+17%。技能仍然有用,但 AI 裸考已经答得不错(83%)
这个对比能帮你发现:技能在哪些场景下价值最高,在哪些场景下可能多余。
分类矩阵:技能在坐标系中的位置
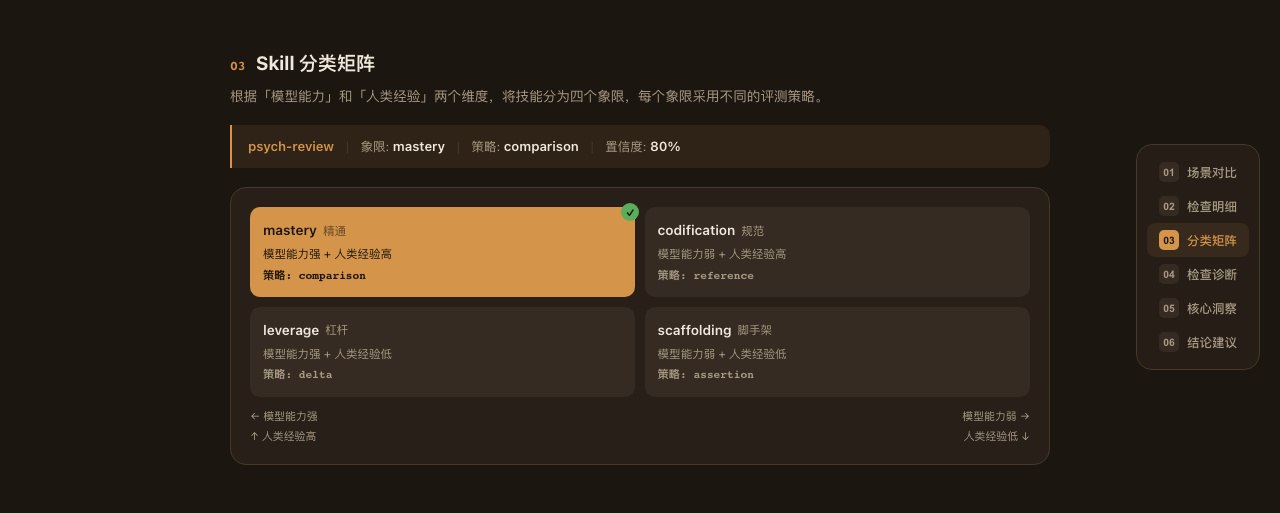
这张 2×2 矩阵图把技能放在一个坐标系里:
- 横轴:AI 模型对这类任务的原生能力(左边强,右边弱)
- 纵轴:技能编码的人类经验(上面高,下面低)
psych-review 位于左上角的 mastery(精通) 象限,标了一个绿色对勾:AI 本身擅长这类任务,同时技能也写得很好,两者的配合需要精细的评测策略才能度量。
检查项诊断:你出的考题质量怎么样
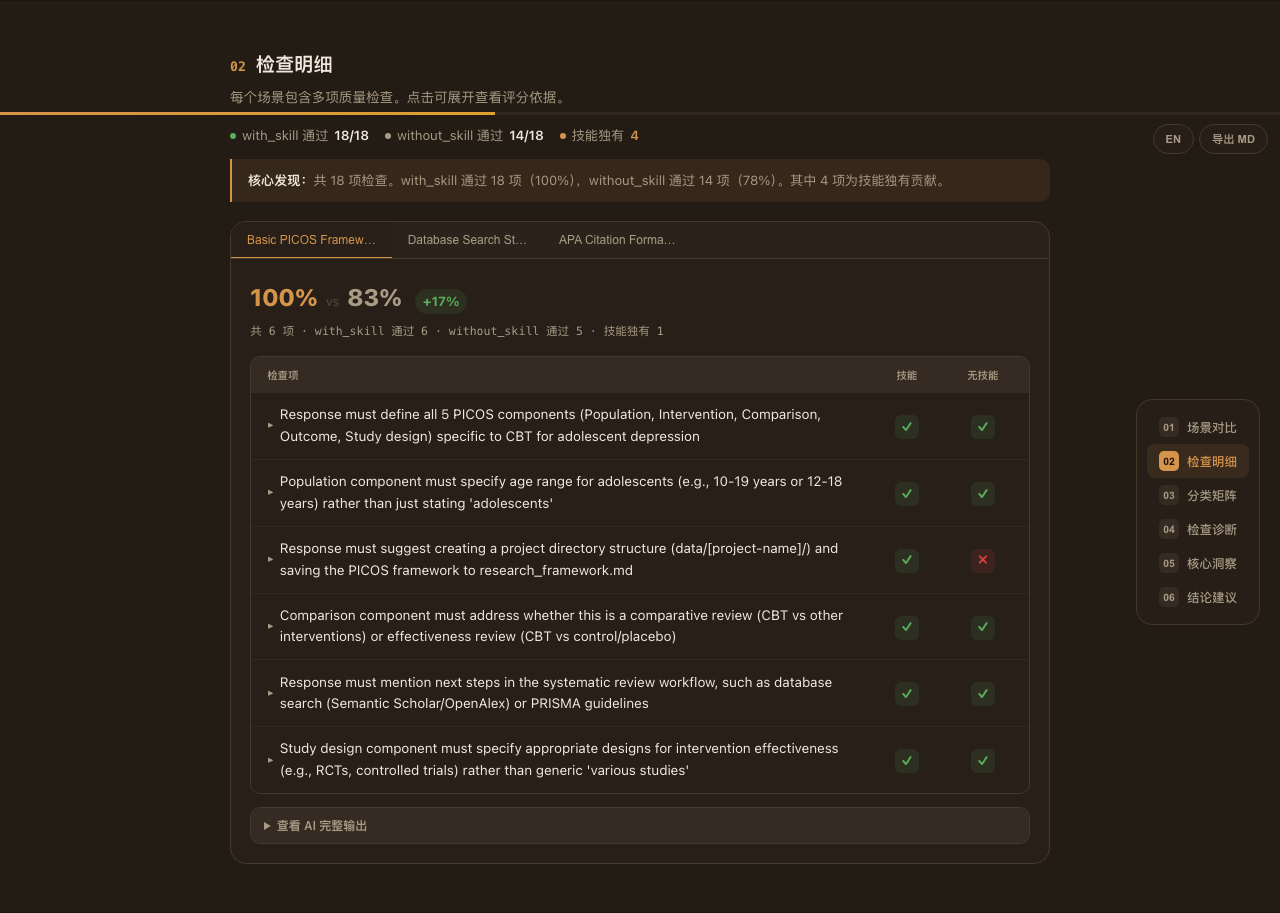
这是报告中信息密度最高的部分:不只评估技能,还反过来评估你的考题设计得好不好。表格每行是一条断言,右边两列 WITH 和 W/O 显示通过次数,诊断结果的含义与处理方式见前文「断言健康度」。
在 psych-review 的报告中,6 条断言全部被标记为「技能价值」,说明每条断言都能有效区分技能的贡献。如果出现「始终通过」,把太简单的断言换掉即可。
核心洞察与结论:一眼看到下一步该做什么
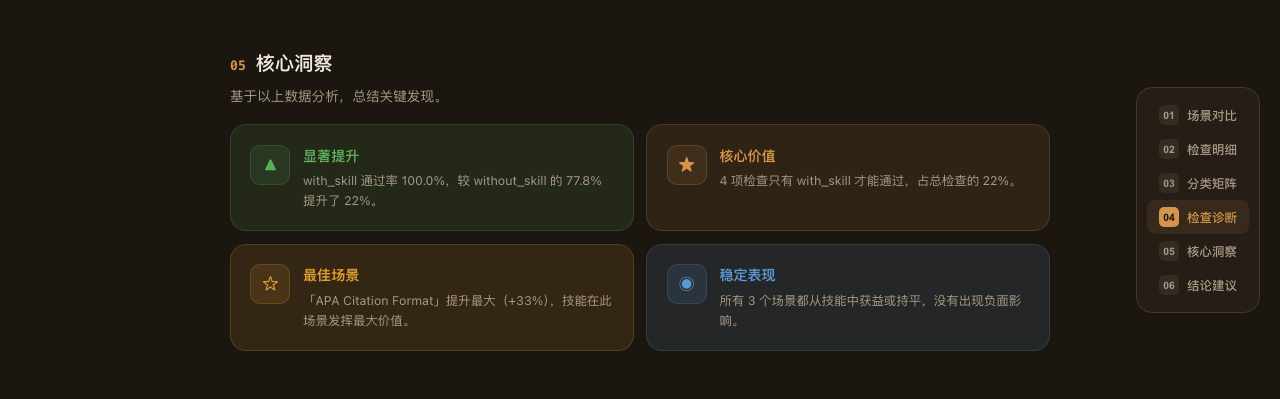
报告最后用四张卡片总结发现:
- 显著提升:通过率从 50% 提升到 100%,技能效果显著
- 核心价值:9 项检查只有带技能才能通过,技能的独有贡献占了一半
- 最佳场景:PICOS 框架定义是技能发挥最大价值的地方
- 稳定表现:所有场景都从技能中获益,没有出现负面影响
底部有两个按钮:「导出 Markdown」方便归档分享,「访问 42plugin.com」回到平台。